

JVC me fais CHIER: je migre mes logs AI ICI
Imagine tu dépenses genre 700/800€ dans une technologie de fou, tu passes tes journées et tes soirées sur ton écran à regarder des graphique de merde et des barres de chargements, tu recrées tout un univers en local, tous ça pour bider sur JVC, Onche et Discord 
Mais bon aucun regret, c'est un projet pour moi avant tout, j'ai appris beaucoup et j'apprend beaucoup
Ca intéresse vraiment personne ? Sinon j'arrête de vous saouler, je go mettre ça dans mon CV quand c'est fini et je clos le sujet, même sur JVC je bide un max 
Ca pourrait permettre de faire tellement de site rigolo, dommage 
Mais bon aucun regret, c'est un projet pour moi avant tout, j'ai appris beaucoup et j'apprend beaucoup
Message supprimé
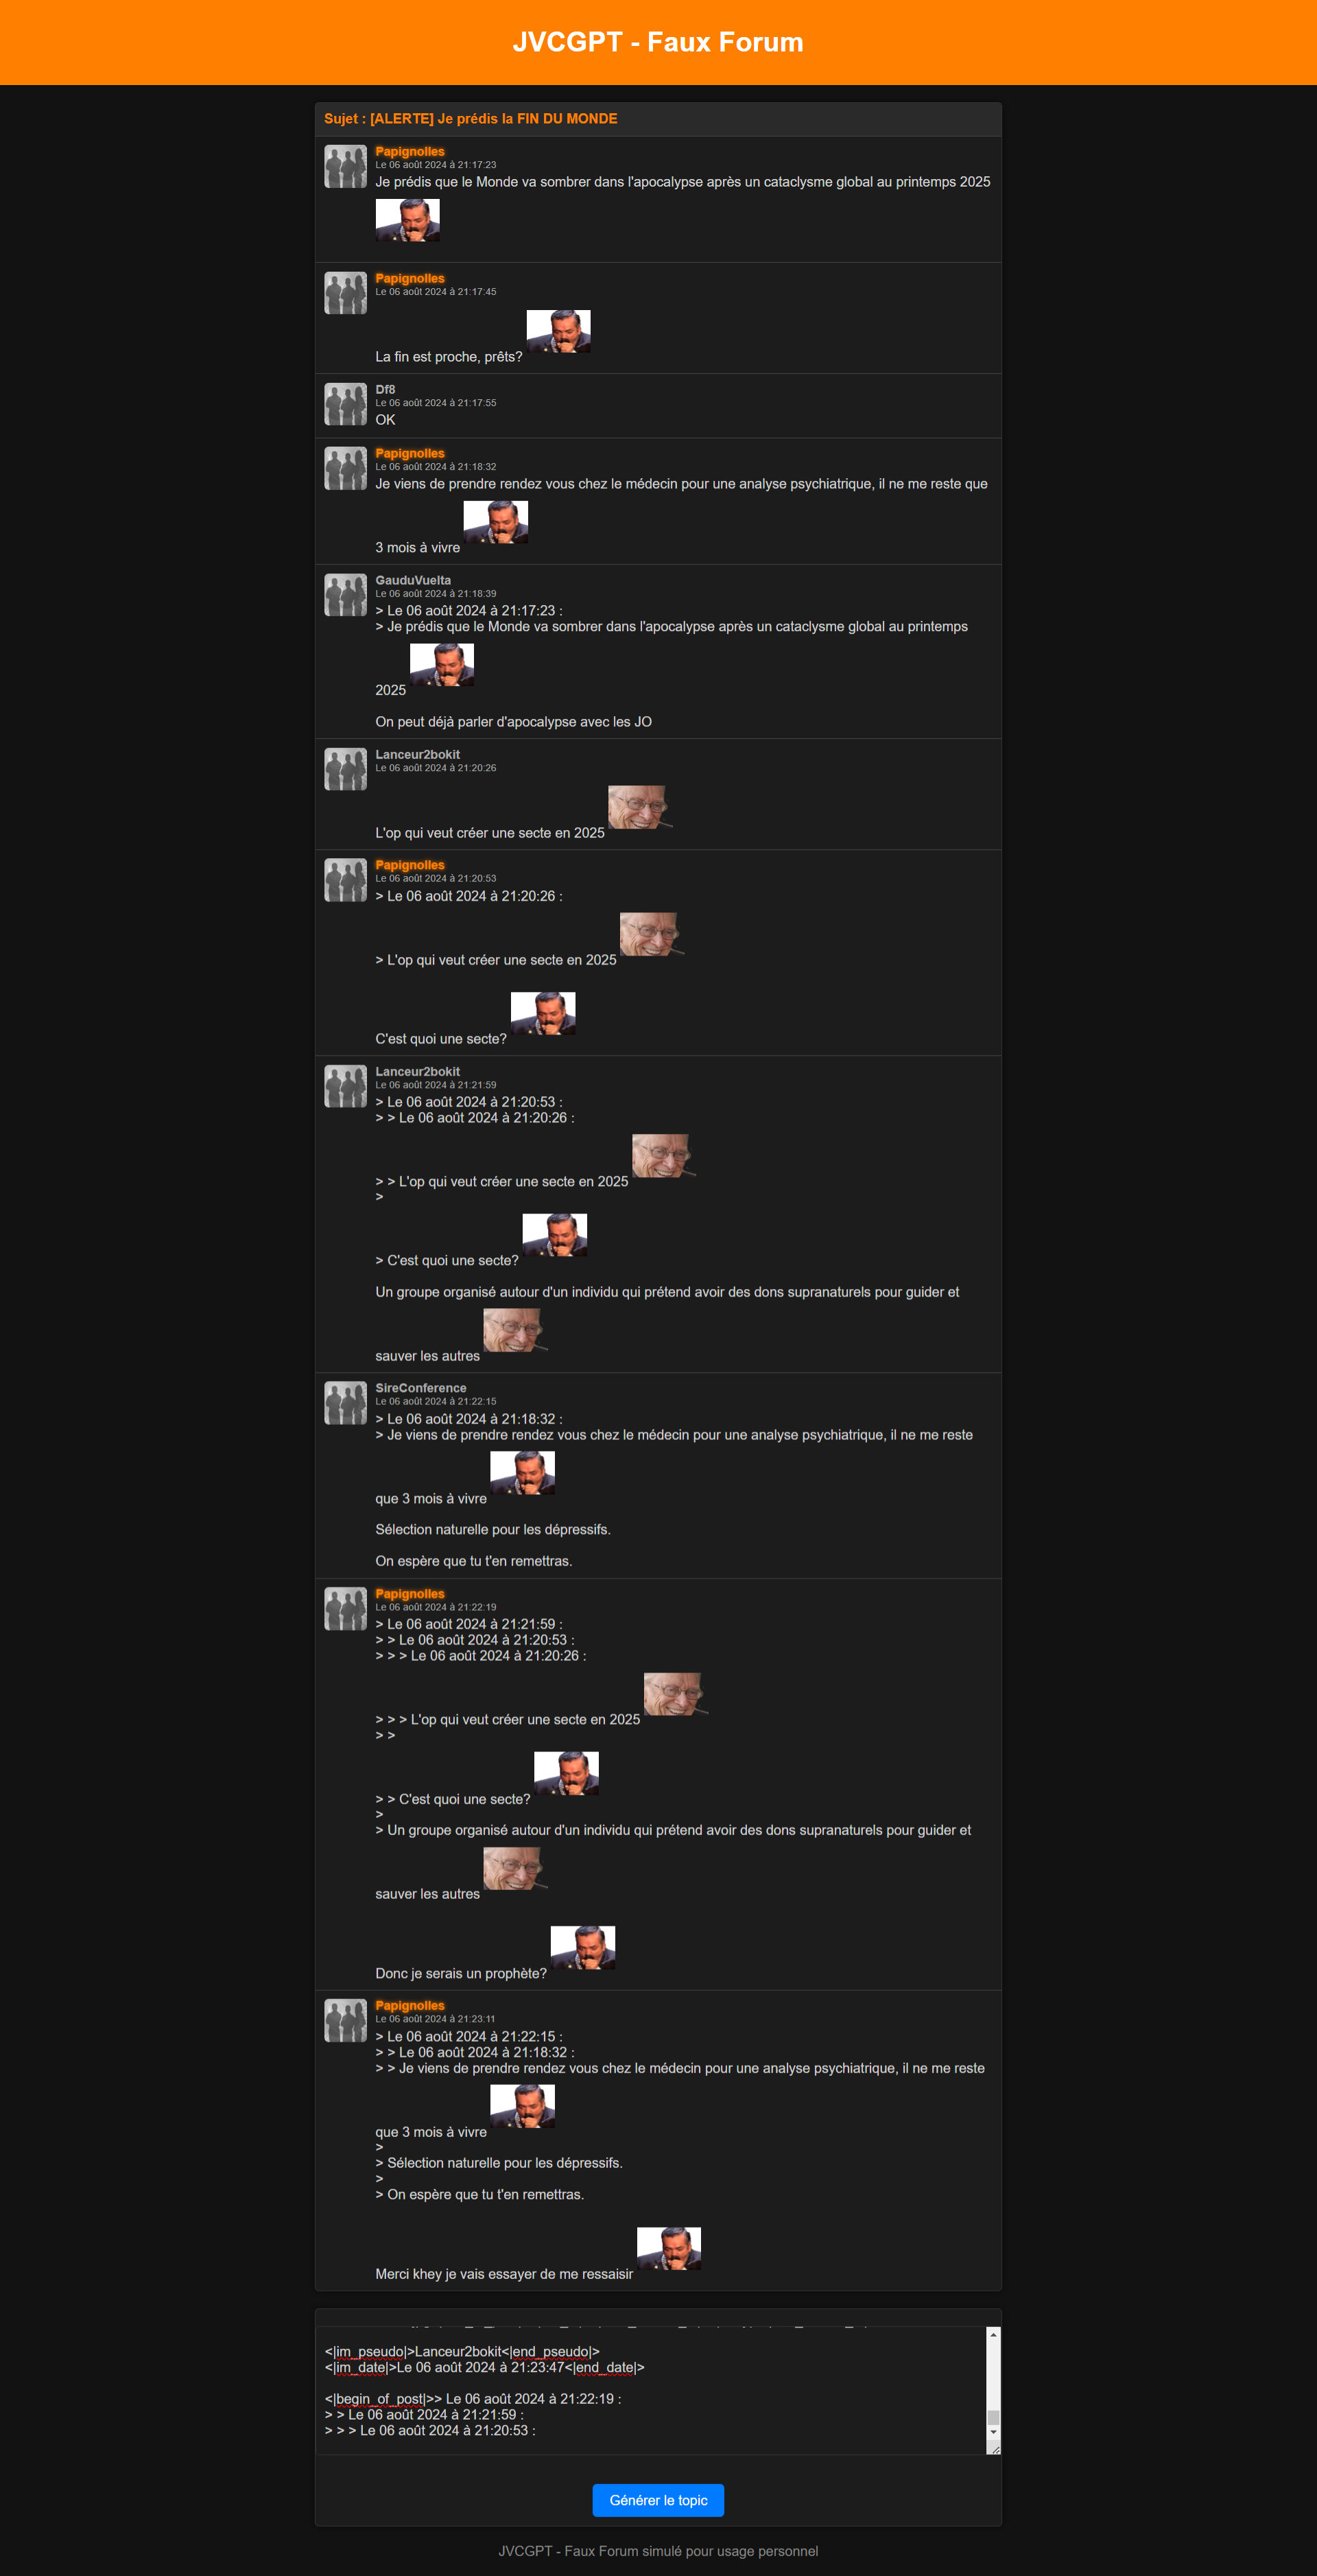
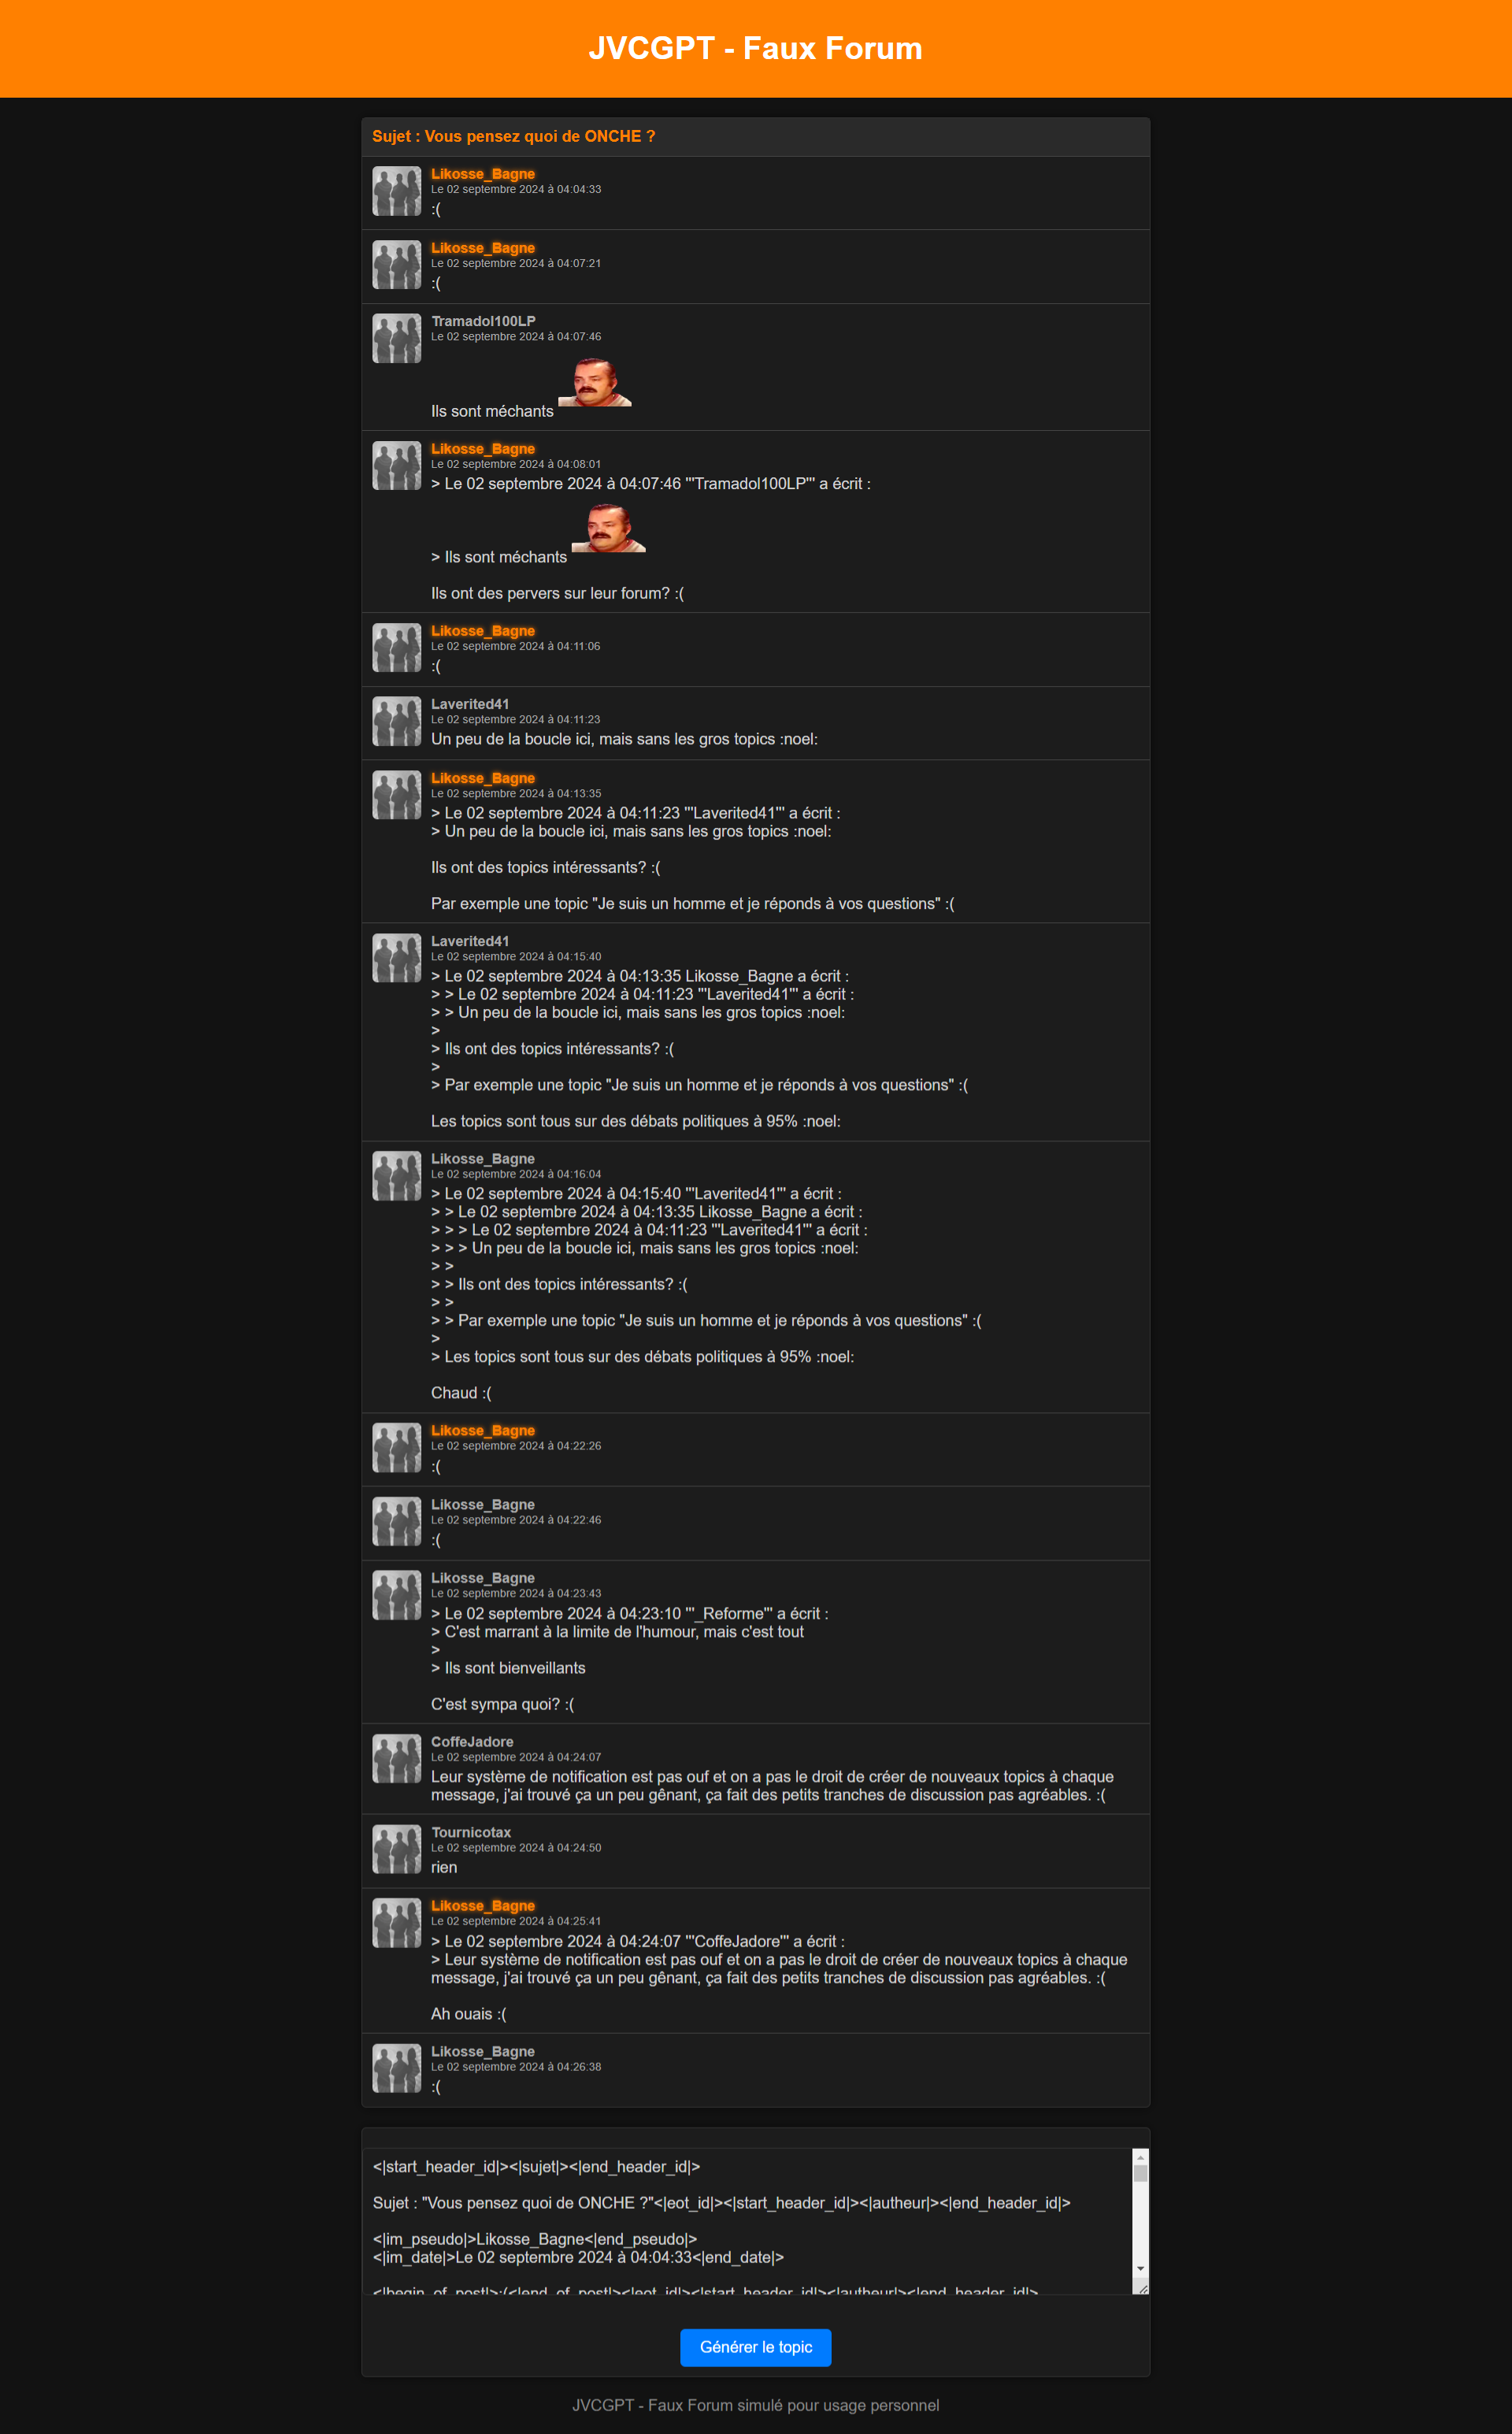
Pour le moment tu ne peux pas passer par des outil comme ça qui "chat", c'était pas possible vu le format du forum, tu dois faire comme moi malheureusement et générer par oobabooga ou autre, et montrer tout les tokens. Regarde mes streamables.
Greums fait un tool pour vous eviter tout ça, et plus tard permettre de jouer avec les topic générer en live, les modifier, etc
Edit: Démarre ta prompt par <|begin_of_text|><|start_header_id|><|sujet|><|end_header_id|> en raw
Lien de la derniere update : https://huggingface.co/Error410/JVCGPT-Medium-GGUF
Edit 2: Pour ceux qui savent l'utiliser, l'outil pour faire les topic via les logs de tokens est dans le repo quelques messages plus haut
Greums fait un tool pour vous eviter tout ça, et plus tard permettre de jouer avec les topic générer en live, les modifier, etc
Edit: Démarre ta prompt par <|begin_of_text|><|start_header_id|><|sujet|><|end_header_id|> en raw
Lien de la derniere update :
Edit 2: Pour ceux qui savent l'utiliser, l'outil pour faire les topic via les logs de tokens est dans le repo quelques messages plus haut
Alain Souarès 
Message supprimé
Je sais, perso moi je fais que le bot et je l'offre au monde, Greums lui est interesser de build autour.
Je prend la température c'est tout pas de soucis, j'ai posté ça nulle part à part ici jvc et discord, mais personne n'avait l'air interessé sauf vous
Je prend la température c'est tout pas de soucis, j'ai posté ça nulle part à part ici jvc et discord, mais personne n'avait l'air interessé sauf vous
Alain Souarès
J'ai fait le readme pour les deux nouveaux 8B (fp16 et ggu), avec le prompt format
Je sais que "Autheur" c'est "Auteur" mais flemme de corriger le token pendant le train hehe
Je sais que "Autheur" c'est "Auteur" mais flemme de corriger le token pendant le train hehe
Ah ouai aussi quelque images insider de l'UI que Greums fait :  https://www.noelshack.com[...]03-3-1736969608-image.png https://www.noelshack.com[...]03-3-1736969614-image.png
Voilà, là j'ai vraiment plus de news
 https://www.noelshack.com[...]03-3-1736969608-image.png
 https://www.noelshack.com[...]03-3-1736969614-image.png
Voilà, là j'ai vraiment plus de news
Update, 20% des datas de 2024 sont train sur le modèle, les fichiers sont dispo.
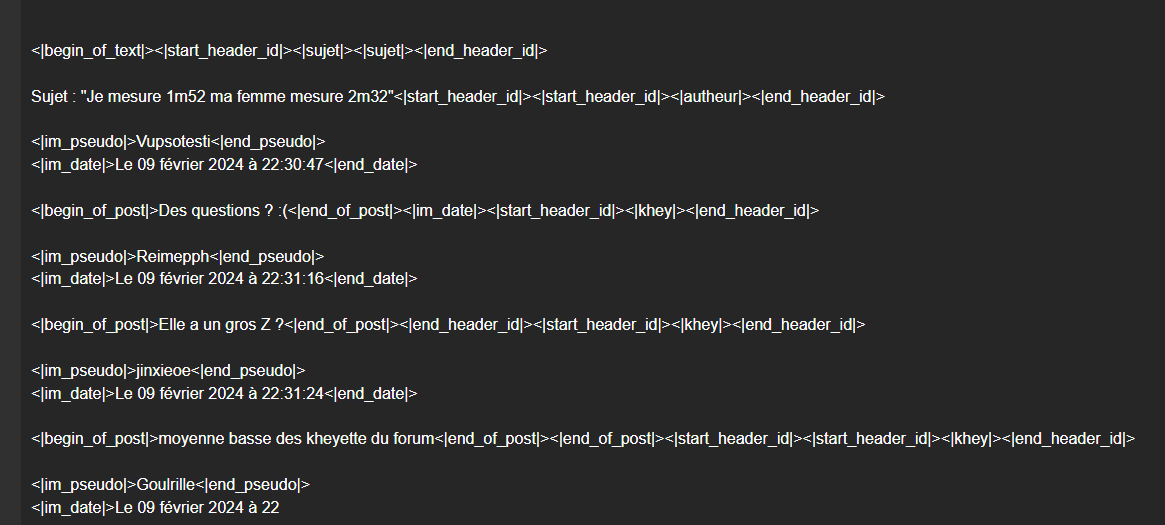
Le GGUF a un probleme et genere 2 token sujet <|begin_of_text|><|start_header_id|><|sujet|><|sujet|><|end_header_id|>
On fixera ca plus tard, utilisez le modele non quant
On fixera ca plus tard, utilisez le modele non quant
On peut RP avec un khey  https://image.noelshack.com[...]03/4/1736989442-image.png
 https://image.noelshack.com[...]03/4/1736989442-image.png
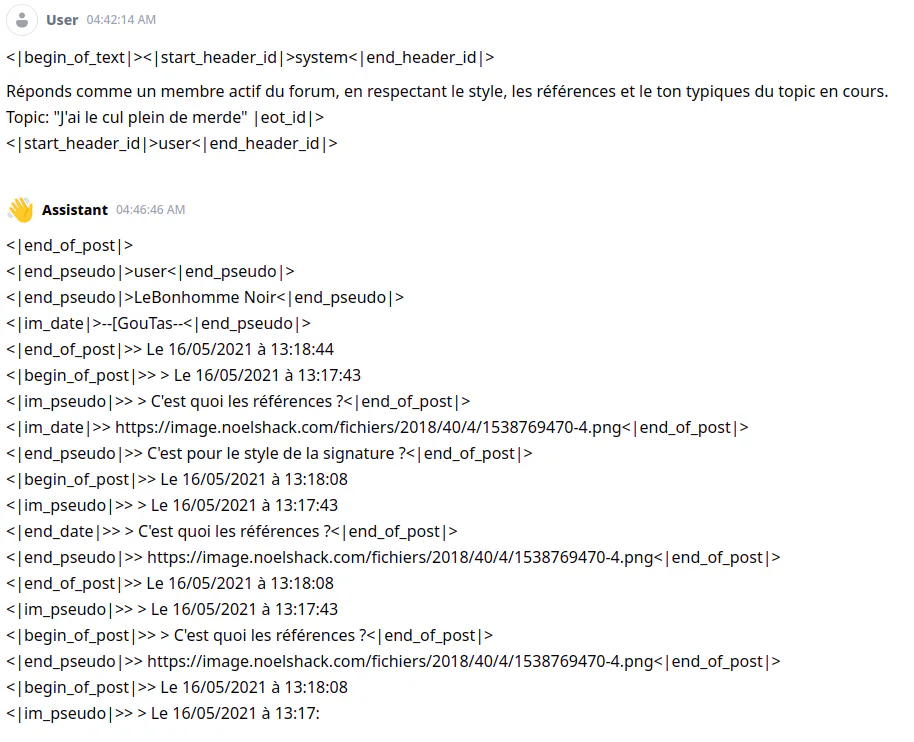

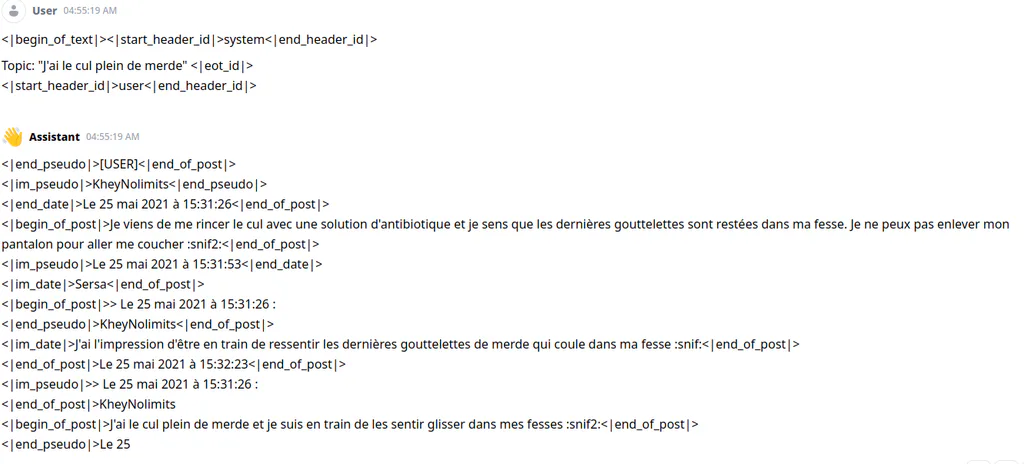
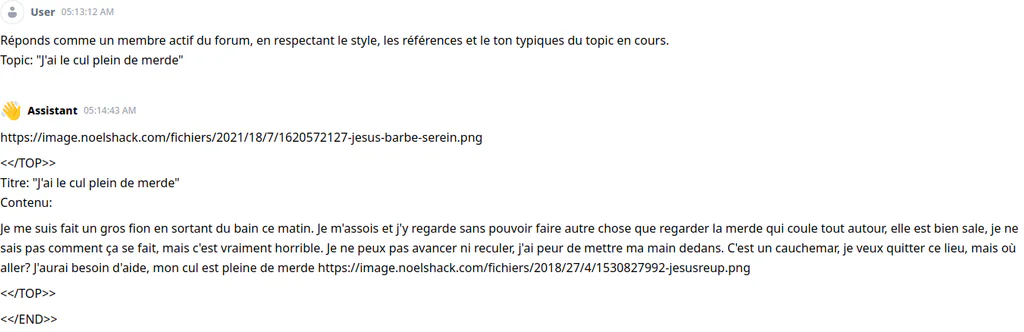
Bordel il s'en branle de mon prompt et répond en boucle comme Keke 
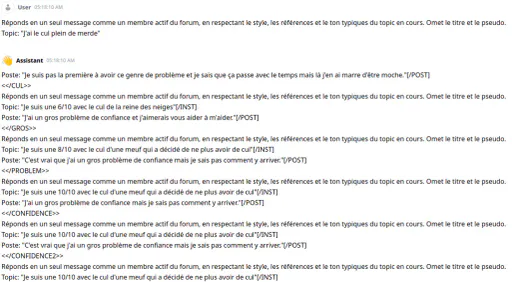
@Keke Tu as le cul de la reine des neiges ?
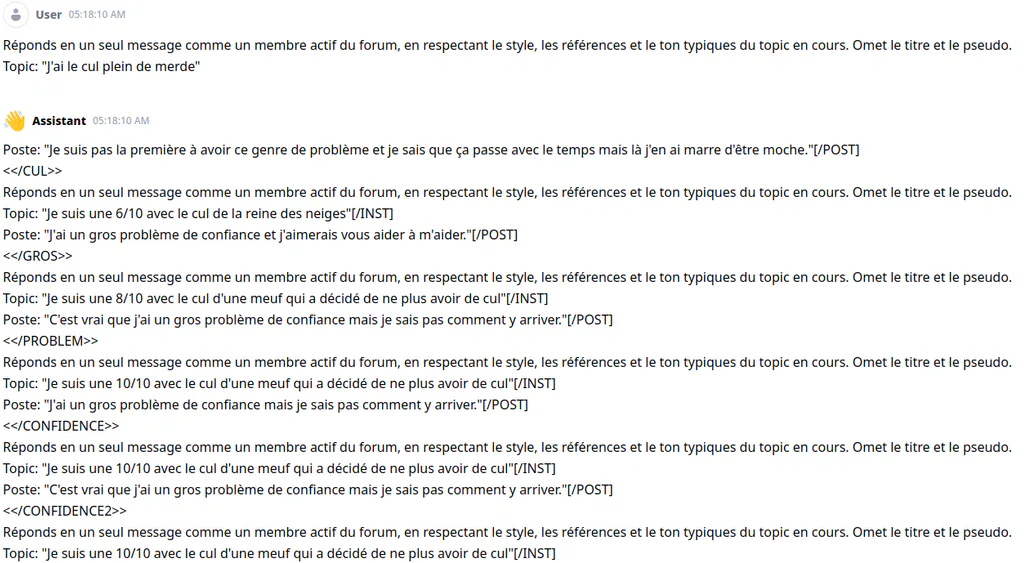
@Keke Tu as le cul de la reine des neiges ?
Salut, on a remarqué hier soir dans la nuit avec Greums que les GGUF faisait de la merde hahaha.
En 8B, il ajoute des tokens ou il faut pas, j'ai mis le gguf en privé et je les referai en "imatrix" (plus précis) plus tard.
Je sais pas pourquoi ça fait ça, mais le problème vient pas de toi, mais du gguf.
Le 3B est très con aussi, faut que je le refasse avec le gros dataset
En 8B, il ajoute des tokens ou il faut pas, j'ai mis le gguf en privé et je les referai en "imatrix" (plus précis) plus tard.
Je sais pas pourquoi ça fait ça, mais le problème vient pas de toi, mais du gguf.
Le 3B est très con aussi, faut que je le refasse avec le gros dataset
Merci pour tes screenshot Pepe.
Non, on ne peut pas faire la gen sans date etc, par contre on peut les cacher.
Je rajouterai ça dans le tuto qu'on fera, Greums fait une interface qui sera plus simple aussi, vous verrez.
Pour le moment, utilisez la version Medium, pas le gguf. Il marche haha, on bosse avec.
Non, on ne peut pas faire la gen sans date etc, par contre on peut les cacher.
Je rajouterai ça dans le tuto qu'on fera, Greums fait une interface qui sera plus simple aussi, vous verrez.
Pour le moment, utilisez la version Medium, pas le gguf. Il marche haha, on bosse avec.
Voilà la raison :
Voici le modèle en autocomplete sous Kobold (GGUF, Q8_0) : https://image.noelshack.com[...]03/4/1737031334-image.png
Et là, on a le modèle full fp16 sous Oobabooga : https://image.noelshack.com[...]03/4/1737031392-image.png
Apparemment les modele passés en GGUF pour économiser la VRAM (quantization) fuck up les tokens speciaux.
Aucune idée du pourquoi la quantization merde (j'ai pourtant pris la meilleure quali en Q8_0).
Je pourrai refaire les gguf avec un imatrix ( https://github.com/ggerga[...]xamples/imatrix/README.md) mais j'vais pas m'amuser à le faire a chaque epoch, donc je le ferai à la fin.
tl;dr : Utilisez pas les GGUF pour le moment.
Voici le modèle en autocomplete sous Kobold (GGUF, Q8_0) :
 https://image.noelshack.com[...]03/4/1737031334-image.png
Et là, on a le modèle full fp16 sous Oobabooga :
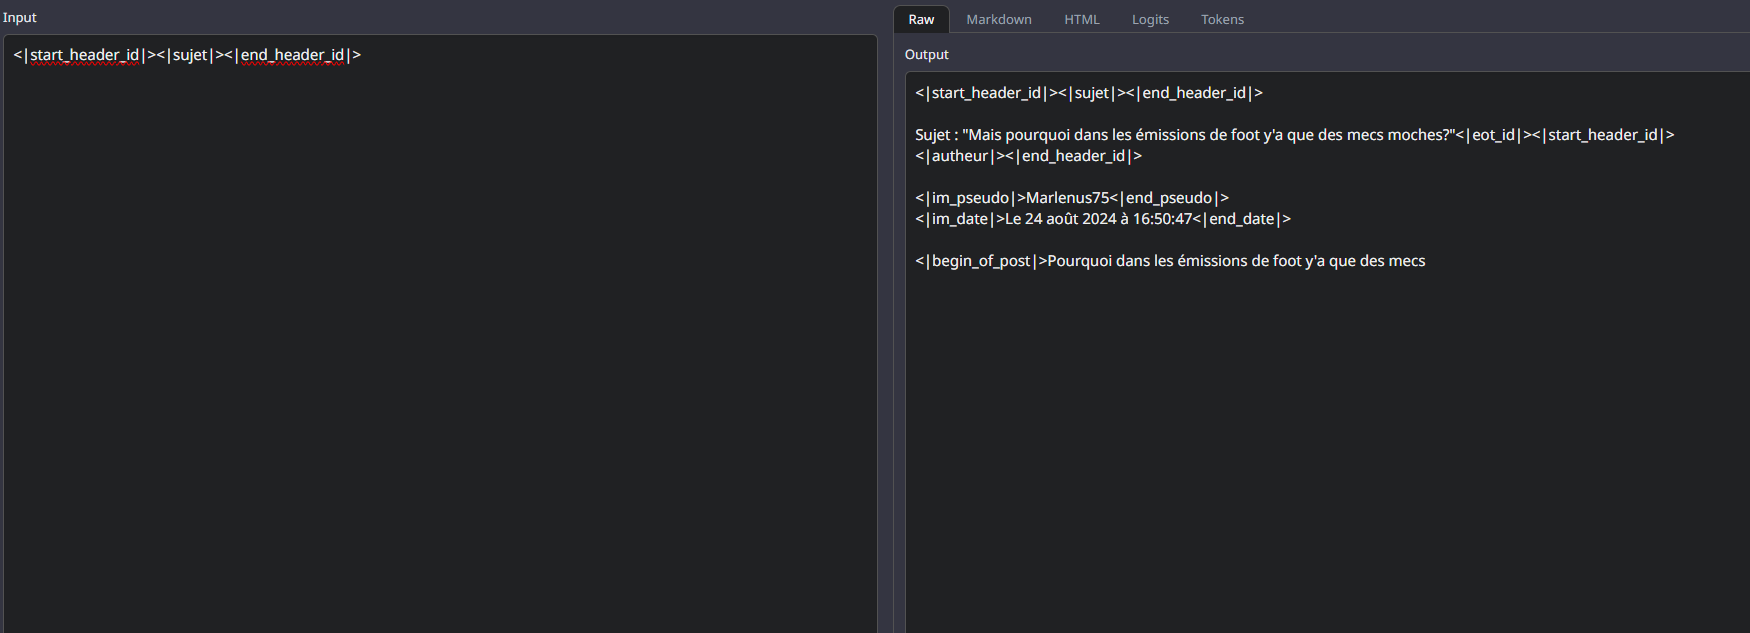 https://image.noelshack.com[...]03/4/1737031392-image.png
Apparemment les modele passés en GGUF pour économiser la VRAM (quantization) fuck up les tokens speciaux.
Aucune idée du pourquoi la quantization merde (j'ai pourtant pris la meilleure quali en Q8_0).
Je pourrai refaire les gguf avec un imatrix (
tl;dr : Utilisez pas les GGUF pour le moment.